

Contexte du projet
Le projet est installé sur une VM Linux Debian (VirtualBox), nous devons déboguer un problème à partir d'un fichier SQL avec des données de production anonymisées. Le fichier SQL fait plusieurs gigaoctets.
Malgré de multiples tentatives d'importation – que ce soit via PhpStorm depuis votre machine hôte, en ligne de commande depuis l'hôte, ou directement au sein de la VM via son terminal – le résultat est systématiquement le même : la VM se fige, l'importation échoue en cours de processus, obligeant à tout reprendre depuis le début.
Solution de contournement
La meilleure solution envisagée, c'est de découper le fichier en plusieurs petits fichiers SQL. Nous pourrons alors importer les fichiers pour compléter le modèle des données à partir de la table qui a planté. Ainsi, chaque fichier pourra être repris jusqu'à l'import complet.
Merci à Kedar Vaijanapurkar, qui a développé un script permettant de manipuler un fichier mysqldump : https://github.com/kedarvj/mysqldumpsplitter/
MySQLDumpSplitter
Pour installer le script https://github.com/kedarvj/mysqldumpsplitter/blob/master/mysqldumpsplitter.sh et ajouter les droits d'exécution :
$ chmod +x mysqldumpsplitter.sh
Lister les tables présentes dans le fichier SQL :
$ ./mysqldumpsplitter.sh --source my_huge_sql_file.sql --desc
Exporter la table la plus grosse, qui plante à chaque tentative :
$ ./mysqldumpsplitter.sh --source my_huge_sql_file.sql --extract REGEXP --match_str 'TABLE_NAME'
On obtient dans le dossier out/ un fichier TABLE_NAME.sql.gz .
Import d'un fichier gzip dans MySQL
Pour l'importer, on va utiliser gunzip avec la commande suivante :
$ gunzip ./out/TABLE_NAME.sql.gz | mysql -h localhost -u <db_user> --password=<db_password> <DBNAME>
Malheureusement, nous n'avons pas beaucoup d'informations sur l'avancée de cet import.
Barre de progression
Il nous faudrait une barre de progression pour plus de visibilité sur l'avancée de l'import :
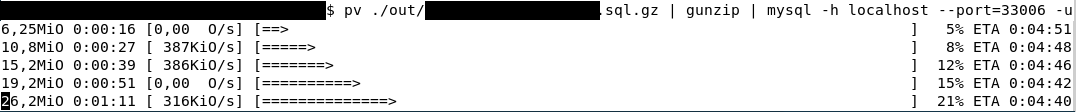
Installer la barre de progression
sudo apt install pv
Utiliser pv
$ pv ./out/TABLE_NAME.sql.gz | gunzip | mysql -h localhost -u <db_user> --password=<db_password> <DBNAME>
Export de plusieurs tables
L'export et l'import fonctionnent parfaitement pour une table ; voici comment en exporter plusieurs :
$ ./mysqldumpsplitter.sh --source my_huge_sql_file.sql --extract REGEXP --match_str '(TABLE_NAME_1|TABLE_NAME_2|TABLE_NAME_3|TABLE_NAME_4|TABLE_NAME_5|TABLE_NAME_6|TABLE_NAME_7|TABLE_NAME_8)'
Script d'import en masse
Nous n'allons pas exécuter une commande par table, on va donc développer un petit script d'import de tous les fichiers présents dans le dossier out/ .
#!/bin/bash
for i in ./out/*.sql.gz
do
    echo "Importing: $i"
    pv $i | gunzip | mysql -h localhost -u <db_user> --password=<db_password> <DBNAME>
    wait
done
Exécution d'un import progressif qui se déroule sans accroc :
$ chmod +x import-sql-gz.sh
$ ./import-sql-gz.sh
Le débogage du projet peut commencer !
Nous vous invitons à nous contacter pour toute demande de débogage de vos solutions ou pour la mise en œuvre de votre projet, n'hésitez pas à nous solliciter.
Nos derniers articles
Dataflow et Ibexa Dataflow 7 : dates en UTC, suivi des jobs enrichi, sécurité renforcée
Depuis notre dernier article, Ibexa Dataflow est passé de la version 6.1.2 à la 7.0.0 ...
Security Audit fait peau neuve : nouveau design, nouveau tableau de bord, toujours gratuit
Nouveau tableau de bord, nouveau design, de nouvelles analyses et une feuille de route ambitieuse ...
Code généré par IA, Shadow Dev et dette technique : comment éviter la déstabilisation de votre application PHP/Symfony ?
Si les assistants IA ont révolutionné la production de code en accélérant significativement le développement, ...
Nouveautés de Dataflow : stockage des logs en fichier et nettoyage automatisé de l'historique
Vous en avez marre d'avoir les logs de vos jobs dans la base de données ...
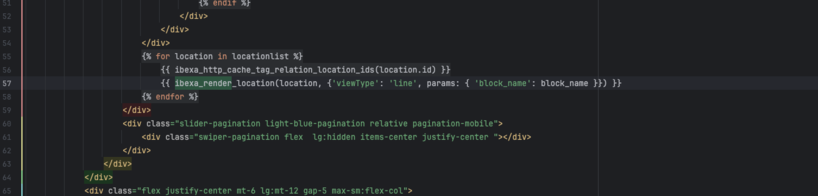
Comment utiliser les paramètres avec ibexa_render et ibexa_render_location
Si vous développez sur Ibexa depuis quelques années, vous avez pris l'habitude, pour passer des ...
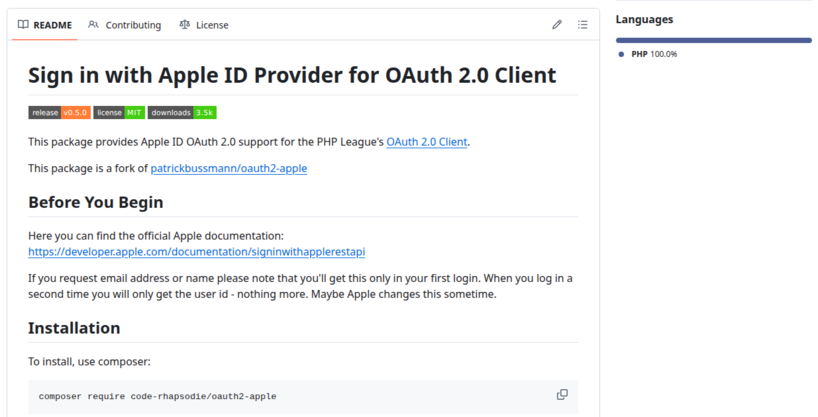
Reprise de la maintenance du provider Apple pour PHP League OAuth2 Client
Code Rhapsodie reprend la maintenance du package oauth2-apple de Patrick Bussmann. Ce fork garantit la ...
Nouvelle fonctionnalité de suggestion de mots-clés au connecteur Gemini pour Ibexa
La suggestion de mots-clés de Taxonomy est disponible dans Ibexa DXP avec le pack de ...
Diviser un fichier SQL volumineux en petits fichiers pour un import facilité
L'importation d'un fichier SQL de très grande taille peut s'avérer problématique, entraînant parfois la saturation ...
Sylius vs Shopware : quelle architecture choisir pour votre futur e-commerce ?
Sylius et Shopware sont deux outils (frameworks) permettant la réalisation d'un site e-commerce. Comment choisir ...